Лабораторная работа № 2 на страницах 36-38, ГДЗ по алгебре за 11 класс к учебнику Бунимовича вероятность и статистика
Задание 1. Средняя длина слова в языке.
Выборки — два текста по 50 слов: стихотворение в прозе И. С. Тургенева «Русский язык» (в нём ровно 50 слов) и первые 50 слов Геттисбергской речи А. Линкольна на английском языке; длина слова — число букв в нём, знаки препинания не считаются. Для каждой выборки находим выборочное среднее, дисперсию и стандартное отклонение длины слова, составляем таблицу частот и сравниваем результаты.
Длины слов русского текста по порядку — выборка объёма \(N = 50\):
2, 3, 8, 2, 3, 9, 8, 1, 7, 4, 6, 2, 4, 3, 9, 1, 5, 1, 7, 7, 9, 1, 9, 7, 4, 2, 4, 4, 3, 2, 6, 1, 8, 3, 4, 5, 3, 11, 4, 2, 6, 6, 5, 5, 4, 2, 3, 3, 8, 6.
Числа вносим в ячейки A1:A50, в ячейки B1:B5 — формулы =СРЗНАЧ(A:A) (выборочное среднее \(\overline{X}\)), =ДИСПР(A:A) (выборочная дисперсия \(S^2\)), =ДИСП(A:A) (исправленная выборочная дисперсия \(S_0^2 = \frac{N}{N - 1}S^2\)), =СТАНДОТКЛОНП(A:A) (стандартное отклонение \(S = \sqrt{S^2}\)) и =СТАНДОТКЛОН(A:A) (\(S_0 = \sqrt{S_0^2}\)).
В ячейки D1:D11 — длины слов от 1 до 11 (самое длинное слово выборки — «совершается», 11 букв).
В ячейку E1 — =СЧЁТЕСЛИ(A:A;D1), копируем вниз до E11: число слов той длины, которая записана в ячейке столбца D той же строки.
В ячейку E12 — =СУММ(E1:E11): получается 50, все слова учтены.
В ячейку F1 — =E1/$E$12, копируем вниз до F11: частоты (адрес $E$12 абсолютный и при копировании не меняется). Таблица частот:
\[\begin{array}{l|c|c|c|c|c|c|c|c|c|c|c} \text{Длина слова} & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 \\ \hline \text{Число слов} & 5 & 7 & 8 & 8 & 4 & 5 & 4 & 4 & 4 & 0 & 1 \\ \hline \text{Частота} & 0{,}1 & 0{,}14 & 0{,}16 & 0{,}16 & 0{,}08 & 0{,}1 & 0{,}08 & 0{,}08 & 0{,}08 & 0 & 0{,}02 \end{array}\]
Числа в ячейках B1:B5 находим и по таблице частот, вычислив ещё среднее арифметическое квадратов \(\overline{X^2}\).
Сумма длин всех слов: \(1 \cdot 5 + 2 \cdot 7 + 3 \cdot 8 + 4 \cdot 8 + 5 \cdot 4 + 6 \cdot 5 + 7 \cdot 4 + 8 \cdot 4 + 9 \cdot 4 + 11 \cdot 1 = 232\).
Сумма их квадратов: \(1^2 \cdot 5 + 2^2 \cdot 7 + 3^2 \cdot 8 + 4^2 \cdot 8 + 5^2 \cdot 4 + 6^2 \cdot 5 + 7^2 \cdot 4 + 8^2 \cdot 4 + 9^2 \cdot 4 + 11^2 \cdot 1 = 1410\), поэтому
\[\begin{aligned} \overline{X} &= \frac{232}{50} = 4{,}64; \\ \overline{X^2} &= \frac{1410}{50} = 28{,}2; \\ S^2 &= \overline{X^2} - \overline{X}^2 = 28{,}2 - 4{,}64^2 = 6{,}6704; \\ S_0^2 &= \frac{50}{49} \cdot 6{,}6704 \approx 6{,}807; \\ S &= \sqrt{6{,}6704} \approx 2{,}583; \\ S_0 &= \sqrt{S_0^2} \approx 2{,}609. \end{aligned}\]
Длины слов английского текста по порядку (\(N = 50\)):
4, 5, 3, 5, 5, 3, 3, 7, 7, 5, 2, 4, 9, 1, 3, 6, 9, 2, 7, 3, 9, 2, 3, 11, 4, 3, 3, 3, 7, 5, 3, 2, 3, 7, 2, 1, 5, 5, 3, 7, 7, 4, 6, 2, 3, 6, 2, 9, 3, 2.
На втором листе вносим эти числа в ячейки A1:A50 и повторяем те же формулы (самое длинное слово — «proposition», тоже 11 букв). Таблица частот:
\[\begin{array}{l|c|c|c|c|c|c|c|c|c|c|c} \text{Длина слова} & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 \\ \hline \text{Число слов} & 2 & 8 & 14 & 4 & 7 & 3 & 7 & 0 & 4 & 0 & 1 \\ \hline \text{Частота} & 0{,}04 & 0{,}16 & 0{,}28 & 0{,}08 & 0{,}14 & 0{,}06 & 0{,}14 & 0 & 0{,}08 & 0 & 0{,}02 \end{array}\]
Сумма длин слов: \(1 \cdot 2 + 2 \cdot 8 + 3 \cdot 14 + 4 \cdot 4 + 5 \cdot 7 + 6 \cdot 3 + 7 \cdot 7 + 9 \cdot 4 + 11 \cdot 1 = 225\).
Сумма их квадратов: \(1^2 \cdot 2 + 2^2 \cdot 8 + 3^2 \cdot 14 + 4^2 \cdot 4 + 5^2 \cdot 7 + 6^2 \cdot 3 + 7^2 \cdot 7 + 9^2 \cdot 4 + 11^2 \cdot 1 = 1295\), поэтому
\[\begin{aligned} \overline{X} &= \frac{225}{50} = 4{,}5; \\ \overline{X^2} &= \frac{1295}{50} = 25{,}9; \\ S^2 &= \overline{X^2} - \overline{X}^2 = 25{,}9 - 4{,}5^2 = 5{,}65; \\ S_0^2 &= \frac{50}{49} \cdot 5{,}65 \approx 5{,}765; \\ S &= \sqrt{5{,}65} \approx 2{,}377; \\ S_0 &= \sqrt{S_0^2} \approx 2{,}401. \end{aligned}\]
В наших выборках средняя длина русского слова — \(4{,}64\) буквы, английского — \(4{,}5\) буквы: русские слова в среднем немного длиннее. Разброс длин у русских слов больше: \(S^2 = 6{,}6704\) и \(S \approx 2{,}583\) против \(S^2 = 5{,}65\) и \(S \approx 2{,}377\) (\(S_0 \approx 2{,}609\) против \(2{,}401\)). В английской выборке гораздо чаще слова из трёх букв (частота \(0{,}28\) против \(0{,}16\)), а в русской — однобуквенные слова «о», «и», «в» (\(0{,}1\) против \(0{,}04\)) и длинные слова из 8 и 9 букв (\(0{,}16\) против \(0{,}08\)), поэтому длины русских слов сильнее разбросаны около среднего. Выборки невелики и взяты каждая из одного текста, так что вывод относится только к ним.
Задание 2. Вычисление характеристик по таблице частот.
Таблица 15 — распределение первичных баллов на профильном ЕГЭ по математике 2022 г. (процент участников для каждого балла от 0 до 31); частота балла — процент, делённый на 100:
\[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ \hline \text{Участников, \%} & 0{,}34 & 0{,}77 & 1{,}71 & 2{,}51 & 3{,}62 & 4{,}6 & 5{,}6 & 6{,}5 \\ \hline \text{Частота} & 0{,}0034 & 0{,}0077 & 0{,}0171 & 0{,}0251 & 0{,}0362 & 0{,}046 & 0{,}056 & 0{,}065 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 8 & 9 & 10 & 11 & 12 & 13 & 14 & 15 \\ \hline \text{Участников, \%} & 7{,}22 & 7{,}23 & 7{,}01 & 6{,}32 & 5{,}72 & 5{,}61 & 5{,}2 & 5{,}91 \\ \hline \text{Частота} & 0{,}0722 & 0{,}0723 & 0{,}0701 & 0{,}0632 & 0{,}0572 & 0{,}0561 & 0{,}052 & 0{,}0591 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 16 & 17 & 18 & 19 & 20 & 21 & 22 & 23 \\ \hline \text{Участников, \%} & 5{,}01 & 5{,}82 & 4{,}21 & 2{,}4 & 1{,}6 & 1{,}4 & 1{,}19 & 0{,}77 \\ \hline \text{Частота} & 0{,}0501 & 0{,}0582 & 0{,}0421 & 0{,}024 & 0{,}016 & 0{,}014 & 0{,}0119 & 0{,}0077 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 24 & 25 & 26 & 27 & 28 & 29 & 30 & 31 \\ \hline \text{Участников, \%} & 0{,}5 & 0{,}44 & 0{,}27 & 0{,}19 & 0{,}12 & 0{,}13 & 0{,}03 & 0{,}05 \\ \hline \text{Частота} & 0{,}005 & 0{,}0044 & 0{,}0027 & 0{,}0019 & 0{,}0012 & 0{,}0013 & 0{,}0003 & 0{,}0005 \end{array}\]
На этапах 1 и 2 вносим баллы 0, 1, …, 31 в ячейки A1:A32, проценты — в ячейки B1:B32.
В ячейку C1 вписываем =B1/100 и копируем вниз до C32 — частоты баллов; сумма процентов таблицы 15 равна 100, поэтому сумма частот равна 1 — данные внесены полностью.
На этапе 3 в ячейку E1 вписываем =СУММПРОИЗВ(A:A;C:C) — выборочное среднее
\[\overline{X} = 0 \cdot 0{,}0034 + 1 \cdot 0{,}0077 + \ldots + 31 \cdot 0{,}0005 = 11{,}4427.\]
На этапе 4 в ячейку D1 вписываем =A1^2 и копируем вниз до D32 — квадраты баллов.
На этапе 5 в ячейку E2 вписываем =СУММПРОИЗВ(D:D;C:C) — среднее арифметическое квадратов
\[\overline{X^2} = 0^2 \cdot 0{,}0034 + 1^2 \cdot 0{,}0077 + \ldots + 31^2 \cdot 0{,}0005 = 159{,}5553.\]
На этапе 6 в ячейку E3 вписываем =E2-E1^2 — выборочная дисперсия по формуле \(S^2 = \overline{X^2} - \overline{X}^2\):
\[S^2 = 159{,}5553 - 11{,}4427^2 = 28{,}61991671 \approx 28{,}62.\]
На этапе 7 в ячейку E4 вписываем =КОРЕНЬ(E3) — стандартное отклонение \(S = \sqrt{28{,}61991671} \approx 5{,}35\). Исправленную дисперсию не находим: объём выборки в таблице не указан.
На этапе 8 — полигон частот по столбцам A и C; штриховая прямая — выборочное среднее \(\overline{X} = 11{,}4427\).
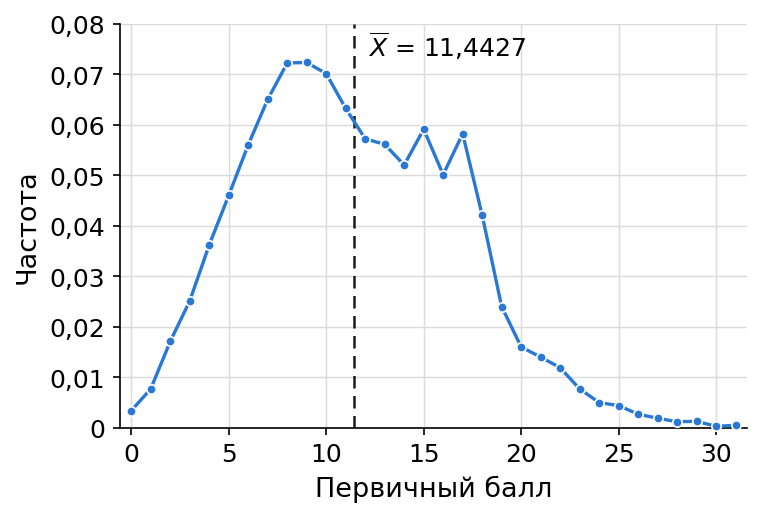
Полигон подтверждает результаты: частоты растут от \(0{,}0034\) при 0 баллов до наибольших \(0{,}0722\) и \(0{,}0723\) при 8 и 9 баллах, остаются больше \(0{,}05\) вплоть до 17 баллов (подъёмы при 15 и 17 баллах: \(0{,}0591\) и \(0{,}0582\)), после 18 баллов резко падают, а правый «хвост» тянется до 31 балла. Среднее \(11{,}4427\) лежит в основной части полигона, немного правее его вершины: длинный правый «хвост» сдвигает среднее вправо. Ошибку было бы видно сразу: если на этапе 3 взять столбец процентов B вместо столбца частот C, получится \(1144{,}27\) — далеко за пределами шкалы от 0 до 31 балла.
Стандартное отклонение тоже согласуется с полигоном. В промежуток \((\overline{X} - S;\ \overline{X} + S) \approx (6{,}09;\ 16{,}79)\) попадают баллы от 7 до 16 — их получили \(61{,}73\) % участников.
В промежуток \((\overline{X} - 2S;\ \overline{X} + 2S) \approx (0{,}74;\ 22{,}14)\) попадают баллы от 1 до 22 — их получили \(97{,}16\) % участников.
Балл наугад выбранного участника имеет математическое ожидание \(\overline{X}\) и стандартное отклонение \(S\) (вероятности — из столбца C); по неравенству Чебышёва он отличается от \(\overline{X}\) меньше чем на \(2S\) с вероятностью не меньше \(1 - \frac{1}{4} = 0{,}75\), а по таблице эта вероятность равна \(0{,}9716\): \(97{,}16\) % больше 75 %.
Ответ: задание 1 — в наших выборках по 50 слов средняя длина русского слова \(\overline{X} = 4{,}64\) буквы (\(S^2 = 6{,}6704\), \(S \approx 2{,}583\)), английского — \(\overline{X} = 4{,}5\) буквы (\(S^2 = 5{,}65\), \(S \approx 2{,}377\)): русские слова в среднем немного длиннее и сильнее различаются по длине; задание 2 — выборочное среднее первичного балла \(\overline{X} = 11{,}4427\), выборочная дисперсия \(S^2 \approx 28{,}62\), стандартное отклонение \(S \approx 5{,}35\).
Задание 1. Средняя длина слова в языке.
Возьмём для примера два текста по 50 слов: русский — стихотворение в прозе И. С. Тургенева «Русский язык» (в нём ровно 50 слов), иностранный — первые 50 слов Геттисбергской речи А. Линкольна на английском языке. Для каждой выборки найдём выборочное среднее, дисперсию и стандартное отклонение длины слова, составим таблицу частот и сравним результаты. Длина слова — число букв в нём, знаки препинания не считаются; длину каждого слова считаем сами и вносим в электронную таблицу числом.
Русский текст: «Во дни сомнений, во дни тягостных раздумий о судьбах моей родины, — ты один мне поддержка и опора, о великий, могучий, правдивый и свободный русский язык! Не будь тебя — как не впасть в отчаяние при виде всего, что совершается дома? Но нельзя верить, чтобы такой язык не был дан великому народу!» Длины его слов по порядку — выборка объёма \(N = 50\):
2, 3, 8, 2, 3, 9, 8, 1, 7, 4, 6, 2, 4, 3, 9, 1, 5, 1, 7, 7, 9, 1, 9, 7, 4, 2, 4, 4, 3, 2, 6, 1, 8, 3, 4, 5, 3, 11, 4, 2, 6, 6, 5, 5, 4, 2, 3, 3, 8, 6.
Вносим эти числа в ячейки A1:A50. В ячейки B1:B5 вписываем по порядку формулы =СРЗНАЧ(A:A) (выборочное среднее \(\overline{X}\)), =ДИСПР(A:A) (выборочная дисперсия \(S^2\)), =ДИСП(A:A) (исправленная выборочная дисперсия \(S_0^2 = \frac{N}{N - 1}S^2\)), =СТАНДОТКЛОНП(A:A) (стандартное отклонение \(S = \sqrt{S^2}\)) и =СТАНДОТКЛОН(A:A) (\(S_0 = \sqrt{S_0^2}\), корень из исправленной дисперсии).
Для таблицы частот в ячейки D1:D11 вписываем возможные длины слов от 1 до 11 (самое длинное слово выборки — «совершается», 11 букв). В ячейку E1 вписываем =СЧЁТЕСЛИ(A:A;D1) и копируем вниз до E11: функция считает слова той длины, которая записана в ячейке столбца D той же строки. В ячейку E12 вписываем =СУММ(E1:E11) — получается 50, значит, все слова учтены. В ячейку F1 вписываем =E1/$E$12 и копируем вниз до F11 — это частоты.
Адрес $E$12 абсолютный: при копировании он не меняется, и каждая строка делит своё число слов на общий объём выборки. Получаем таблицу частот:
\[\begin{array}{l|c|c|c|c|c|c|c|c|c|c|c} \text{Длина слова} & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 \\ \hline \text{Число слов} & 5 & 7 & 8 & 8 & 4 & 5 & 4 & 4 & 4 & 0 & 1 \\ \hline \text{Частота} & 0{,}1 & 0{,}14 & 0{,}16 & 0{,}16 & 0{,}08 & 0{,}1 & 0{,}08 & 0{,}08 & 0{,}08 & 0 & 0{,}02 \end{array}\]
Числа в ячейках B1:B5 найдём и по таблице частот, вычислив ещё среднее арифметическое квадратов \(\overline{X^2}\). Сумма длин всех слов равна \(1 \cdot 5 + 2 \cdot 7 + 3 \cdot 8 + 4 \cdot 8 + 5 \cdot 4 + 6 \cdot 5 + 7 \cdot 4 + 8 \cdot 4 + 9 \cdot 4 + 11 \cdot 1 = 232\), сумма их квадратов — \(1^2 \cdot 5 + 2^2 \cdot 7 + 3^2 \cdot 8 + 4^2 \cdot 8 + 5^2 \cdot 4 + 6^2 \cdot 5 + 7^2 \cdot 4 + 8^2 \cdot 4 + 9^2 \cdot 4 + 11^2 \cdot 1 = 1410\), поэтому
\[\begin{aligned} \overline{X} &= \frac{232}{50} = 4{,}64; \\ \overline{X^2} &= \frac{1410}{50} = 28{,}2; \\ S^2 &= \overline{X^2} - \overline{X}^2 = 28{,}2 - 4{,}64^2 = 6{,}6704; \\ S_0^2 &= \frac{50}{49} \cdot 6{,}6704 \approx 6{,}807; \\ S &= \sqrt{6{,}6704} \approx 2{,}583; \\ S_0 &= \sqrt{S_0^2} \approx 2{,}609. \end{aligned}\]
Английский текст: «Four score and seven years ago our fathers brought forth on this continent, a new nation, conceived in Liberty, and dedicated to the proposition that all men are created equal. Now we are engaged in a great civil war, testing whether that nation, or any nation so conceived and so…» Длины его слов по порядку (\(N = 50\)):
4, 5, 3, 5, 5, 3, 3, 7, 7, 5, 2, 4, 9, 1, 3, 6, 9, 2, 7, 3, 9, 2, 3, 11, 4, 3, 3, 3, 7, 5, 3, 2, 3, 7, 2, 1, 5, 5, 3, 7, 7, 4, 6, 2, 3, 6, 2, 9, 3, 2.
На втором листе вносим эти числа в ячейки A1:A50 и повторяем те же формулы (самое длинное слово — «proposition», тоже 11 букв). Получаем таблицу частот:
\[\begin{array}{l|c|c|c|c|c|c|c|c|c|c|c} \text{Длина слова} & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10 & 11 \\ \hline \text{Число слов} & 2 & 8 & 14 & 4 & 7 & 3 & 7 & 0 & 4 & 0 & 1 \\ \hline \text{Частота} & 0{,}04 & 0{,}16 & 0{,}28 & 0{,}08 & 0{,}14 & 0{,}06 & 0{,}14 & 0 & 0{,}08 & 0 & 0{,}02 \end{array}\]
Сумма длин слов равна \(1 \cdot 2 + 2 \cdot 8 + 3 \cdot 14 + 4 \cdot 4 + 5 \cdot 7 + 6 \cdot 3 + 7 \cdot 7 + 9 \cdot 4 + 11 \cdot 1 = 225\), сумма их квадратов — \(1^2 \cdot 2 + 2^2 \cdot 8 + 3^2 \cdot 14 + 4^2 \cdot 4 + 5^2 \cdot 7 + 6^2 \cdot 3 + 7^2 \cdot 7 + 9^2 \cdot 4 + 11^2 \cdot 1 = 1295\), поэтому
\[\begin{aligned} \overline{X} &= \frac{225}{50} = 4{,}5; \\ \overline{X^2} &= \frac{1295}{50} = 25{,}9; \\ S^2 &= \overline{X^2} - \overline{X}^2 = 25{,}9 - 4{,}5^2 = 5{,}65; \\ S_0^2 &= \frac{50}{49} \cdot 5{,}65 \approx 5{,}765; \\ S &= \sqrt{5{,}65} \approx 2{,}377; \\ S_0 &= \sqrt{S_0^2} \approx 2{,}401. \end{aligned}\]
Сравним результаты. В наших выборках средняя длина русского слова — \(4{,}64\) буквы, английского — \(4{,}5\) буквы: русские слова в среднем немного длиннее. Разброс длин у русских слов больше: \(S^2 = 6{,}6704\) и \(S \approx 2{,}583\) против \(S^2 = 5{,}65\) и \(S \approx 2{,}377\) (по исправленным значениям то же: \(S_0 \approx 2{,}609\) против \(2{,}401\)). Таблицы частот показывают, откуда разница: в английской выборке гораздо чаще слова из трёх букв (частота \(0{,}28\) против \(0{,}16\)), а в русской — однобуквенные слова «о», «и», «в» (\(0{,}1\) против \(0{,}04\)) и длинные слова из 8 и 9 букв (\(0{,}16\) против \(0{,}08\)), поэтому длины русских слов сильнее разбросаны около среднего. Обе выборки невелики и взяты каждая из одного текста, так что вывод относится к этим выборкам; чтобы надёжнее сравнить языки, слова нужно отбирать случайно из многих разных текстов, а объём выборок увеличить.
Задание 2. Вычисление характеристик по таблице частот.
В таблице 15 дано распределение первичных баллов на профильном ЕГЭ по математике 2022 г.: для каждого балла от 0 до 31 — процент участников, получивших этот балл. Частота балла — этот процент, делённый на 100:
\[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ \hline \text{Участников, \%} & 0{,}34 & 0{,}77 & 1{,}71 & 2{,}51 & 3{,}62 & 4{,}6 & 5{,}6 & 6{,}5 \\ \hline \text{Частота} & 0{,}0034 & 0{,}0077 & 0{,}0171 & 0{,}0251 & 0{,}0362 & 0{,}046 & 0{,}056 & 0{,}065 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 8 & 9 & 10 & 11 & 12 & 13 & 14 & 15 \\ \hline \text{Участников, \%} & 7{,}22 & 7{,}23 & 7{,}01 & 6{,}32 & 5{,}72 & 5{,}61 & 5{,}2 & 5{,}91 \\ \hline \text{Частота} & 0{,}0722 & 0{,}0723 & 0{,}0701 & 0{,}0632 & 0{,}0572 & 0{,}0561 & 0{,}052 & 0{,}0591 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 16 & 17 & 18 & 19 & 20 & 21 & 22 & 23 \\ \hline \text{Участников, \%} & 5{,}01 & 5{,}82 & 4{,}21 & 2{,}4 & 1{,}6 & 1{,}4 & 1{,}19 & 0{,}77 \\ \hline \text{Частота} & 0{,}0501 & 0{,}0582 & 0{,}0421 & 0{,}024 & 0{,}016 & 0{,}014 & 0{,}0119 & 0{,}0077 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c|c} \text{Балл} & 24 & 25 & 26 & 27 & 28 & 29 & 30 & 31 \\ \hline \text{Участников, \%} & 0{,}5 & 0{,}44 & 0{,}27 & 0{,}19 & 0{,}12 & 0{,}13 & 0{,}03 & 0{,}05 \\ \hline \text{Частота} & 0{,}005 & 0{,}0044 & 0{,}0027 & 0{,}0019 & 0{,}0012 & 0{,}0013 & 0{,}0003 & 0{,}0005 \end{array}\]
На этапах 1 и 2 вносим баллы 0, 1, …, 31 в ячейки A1:A32, а проценты из таблицы 15 — в ячейки B1:B32. В ячейку C1 вписываем =B1/100 и копируем вниз до C32: в столбце C получаются частоты баллов. Сумма процентов таблицы 15 равна 100, поэтому сумма частот в столбце C равна 1 — данные внесены полностью.
На этапе 3 в ячейку E1 вписываем =СУММПРОИЗВ(A:A;C:C): функция умножает каждый балл на его частоту и складывает произведения — получается выборочное среднее
\[\overline{X} = 0 \cdot 0{,}0034 + 1 \cdot 0{,}0077 + \ldots + 31 \cdot 0{,}0005 = 11{,}4427.\]
На этапе 4 в ячейку D1 вписываем =A1^2 и копируем вниз до D32 — это квадраты баллов. На этапе 5 в ячейку E2 вписываем =СУММПРОИЗВ(D:D;C:C) и получаем среднее арифметическое квадратов
\[\overline{X^2} = 0^2 \cdot 0{,}0034 + 1^2 \cdot 0{,}0077 + \ldots + 31^2 \cdot 0{,}0005 = 159{,}5553.\]
На этапе 6 в ячейку E3 вписываем =E2-E1^2 — выборочная дисперсия по формуле \(S^2 = \overline{X^2} - \overline{X}^2\):
\[S^2 = 159{,}5553 - 11{,}4427^2 = 28{,}61991671 \approx 28{,}62.\]
На этапе 7 в ячейку E4 вписываем =КОРЕНЬ(E3) — выборочное стандартное отклонение \(S = \sqrt{28{,}61991671} \approx 5{,}35\). Исправленную дисперсию здесь не находим: объём выборки в таблице не указан.
На этапе 8 построим полигон частот по столбцам A и C; штриховая прямая отмечает выборочное среднее \(\overline{X} = 11{,}4427\).
Полигон подтверждает полученные результаты. Частоты растут от \(0{,}0034\) при 0 баллов до наибольших \(0{,}0722\) и \(0{,}0723\) при 8 и 9 баллах, остаются больше \(0{,}05\) вплоть до 17 баллов (ещё два подъёма — при 15 и 17 баллах: \(0{,}0591\) и \(0{,}0582\)), после 18 баллов резко падают, а правый «хвост» тянется до 31 балла. Выборочное среднее \(11{,}4427\) лежит в основной части полигона, немного правее его вершины: длинный правый «хвост» сдвигает среднее вправо. Ошибку в вычислениях было бы видно сразу: если на этапе 3 взять столбец процентов B вместо столбца частот C, получится \(1144{,}27\) — далеко за пределами шкалы от 0 до 31 балла.
Стандартное отклонение тоже согласуется с полигоном. В промежуток \((\overline{X} - S;\ \overline{X} + S) \approx (6{,}09;\ 16{,}79)\) попадают баллы от 7 до 16 — их получили \(61{,}73\) % участников, а в промежуток \((\overline{X} - 2S;\ \overline{X} + 2S) \approx (0{,}74;\ 22{,}14)\) — баллы от 1 до 22, их получили \(97{,}16\) % участников. Балл участника, выбранного наугад, принимает значения 0, 1, …, 31 с вероятностями из столбца C, поэтому его математическое ожидание равно \(\overline{X}\), а стандартное отклонение — \(S\). По неравенству Чебышёва этот балл отличается от \(\overline{X}\) меньше чем на \(2S\) с вероятностью не меньше \(1 - \frac{1}{4} = 0{,}75\); по таблице эта вероятность равна \(0{,}9716\), и \(97{,}16\) % больше 75 %.
Ответ: задание 1 — в наших выборках по 50 слов средняя длина русского слова \(\overline{X} = 4{,}64\) буквы (\(S^2 = 6{,}6704\), \(S \approx 2{,}583\)), английского — \(\overline{X} = 4{,}5\) буквы (\(S^2 = 5{,}65\), \(S \approx 2{,}377\)): русские слова в среднем немного длиннее и сильнее различаются по длине; задание 2 — выборочное среднее первичного балла \(\overline{X} = 11{,}4427\), выборочная дисперсия \(S^2 \approx 28{,}62\), стандартное отклонение \(S \approx 5{,}35\).


