Лабораторная работа № 3 на страницах 94-95, ГДЗ по алгебре за 11 класс к учебнику Бунимовича вероятность и статистика
Задание 1. Моделирование показательной случайной величины.
Моделируем 500 значений показательной случайной величины с параметром \(\lambda = 2\). Формулы годятся для любой серии случайных чисел; числа и графики — для одной серии (после нажатия клавиши F9 серия будет другой).
На этапе 1 вписываем в ячейку D1 значение \(\lambda = 2\).
На этапе 2 вписываем в ячейку A1 формулу =СЛЧИС() и копируем её вниз до A500: столбец A — 500 значений случайной величины \(X\), равномерно распределённой на промежутке \((0;\ 1)\).
На этапе 3 вписываем в ячейку B1 формулу =-LN(1-A1)/$D$1 и копируем её вниз до B500: функция \(x = -\frac{\ln(1 - y)}{\lambda}\) — обратная к функции распределения показательного закона \(F(x) = 1 - e^{-\lambda x}\) (\(x \geqslant 0\)), поэтому величина \(Y = -\frac{\ln(1 - X)}{\lambda}\) имеет показательное распределение с параметром \(\lambda\). Адрес $D$1 абсолютный: при копировании он не меняется, и все строки делят на одно и то же \(\lambda\) (относительный адрес D1 в строке 2 превратился бы в D2, где записано другое число).
Первые 10 строк листа в этой серии (числа в столбце A округлены до десятитысячных, в столбце B — до тысячных):
\[\begin{array}{|c|c|c|} \hline \text{Строка} & \text{A} & \text{B} \\ \hline 1 & 0{,}9083 & 1{,}195 \\ \hline 2 & 0{,}3514 & 0{,}216 \\ \hline 3 & 0{,}8150 & 0{,}844 \\ \hline 4 & 0{,}4737 & 0{,}321 \\ \hline 5 & 0{,}5135 & 0{,}360 \\ \hline 6 & 0{,}6463 & 0{,}520 \\ \hline 7 & 0{,}6917 & 0{,}588 \\ \hline 8 & 0{,}1761 & 0{,}097 \\ \hline 9 & 0{,}8664 & 1{,}006 \\ \hline 10 & 0{,}3451 & 0{,}212 \\ \hline \end{array}\]
На этапе 4 вписываем в ячейки C2, C3 и C4 формулы =СРЗНАЧ(B1:B500), =ДИСПР(B1:B500) и =СТАНДОТКЛОНП(B1:B500) — выборочное среднее \(\overline{Y}\), выборочную дисперсию \(S^2\) и стандартное отклонение \(S = \sqrt{S^2}\). В этой серии \(\overline{Y} \approx 0{,}503\), \(S^2 \approx 0{,}248\), \(S \approx 0{,}498\).
На этапе 5 вписываем в ячейки D2, D3 и D4 формулы =1/D1, =1/D1^2 и =1/D1 — математическое ожидание \(E(Y) = \frac{1}{\lambda}\), дисперсию \(D(Y) = \frac{1}{\lambda^2}\) и стандартное отклонение \(\sigma = \frac{1}{\lambda}\) показательного закона. При \(\lambda = 2\) получаем \(E(Y) = 0{,}5\), \(D(Y) = 0{,}25\), \(\sigma = 0{,}5\): выборочные характеристики \(0{,}503\); \(0{,}248\); \(0{,}498\) отличаются от теоретических меньше чем на \(0{,}005\).
На этапе 6 строим гистограмму частот и график плотности. Наименьшее значение выборки равно \(0{,}0015\), наибольшее — \(2{,}692\), поэтому промежуток от 0 до \(2{,}8\) разбиваем на 14 интервалов длины \(0{,}2\): в ячейку E1 вписываем 0, в ячейку F1 — =E1+0,2, в ячейку E2 — =F1; ячейку E2 копируем вниз до E14, а ячейку F1 — до F14.
В ячейку G1 вписываем =СЧЁТЕСЛИ($B$1:$B$500;"<"&F1)-СЧЁТЕСЛИ($B$1:$B$500;"<"&E1) и копируем вниз до G14: условие "<"&F1 означает «значения, меньшие числа из ячейки F1», поэтому разность — число значений выборки в интервале от числа из E1 (включительно) до числа из F1.
В ячейку H1 вписываем =G1/500/0,2 — частоту интервала, делённую на его длину (тогда сумма площадей столбиков равна 1, как площадь под графиком плотности), в ячейку I1 — =$D$1*EXP(-$D$1*(E1+F1)/2), значение плотности \(p(x) = \lambda e^{-\lambda x}\) в середине интервала (EXP(x) — число \(e\) в степени \(x\)), и копируем обе формулы вниз до строки 14.
Строки таблицы — столбцы листа: E и F — концы интервала, G — число значений в нём, H — высота столбика, I — плотность в середине интервала (округлена до десятитысячных):
\[\begin{array}{l|c|c|c|c|c|c|c} \text{E} & 0 & 0{,}2 & 0{,}4 & 0{,}6 & 0{,}8 & 1 & 1{,}2 \\ \hline \text{F} & 0{,}2 & 0{,}4 & 0{,}6 & 0{,}8 & 1 & 1{,}2 & 1{,}4 \\ \hline \text{G} & 160 & 114 & 81 & 44 & 31 & 21 & 12 \\ \hline \text{H} & 1{,}6 & 1{,}14 & 0{,}81 & 0{,}44 & 0{,}31 & 0{,}21 & 0{,}12 \\ \hline \text{I} & 1{,}6375 & 1{,}0976 & 0{,}7358 & 0{,}4932 & 0{,}3306 & 0{,}2216 & 0{,}1485 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c} \text{E} & 1{,}4 & 1{,}6 & 1{,}8 & 2 & 2{,}2 & 2{,}4 & 2{,}6 \\ \hline \text{F} & 1{,}6 & 1{,}8 & 2 & 2{,}2 & 2{,}4 & 2{,}6 & 2{,}8 \\ \hline \text{G} & 15 & 6 & 3 & 7 & 2 & 3 & 1 \\ \hline \text{H} & 0{,}15 & 0{,}06 & 0{,}03 & 0{,}07 & 0{,}02 & 0{,}03 & 0{,}01 \\ \hline \text{I} & 0{,}0996 & 0{,}0667 & 0{,}0447 & 0{,}03 & 0{,}0201 & 0{,}0135 & 0{,}009 \end{array}\]
Сумма чисел столбца G равна 500 — все значения выборки учтены. По столбцам H и I строим на одном графике гистограмму частот и график плотности \(p(x) = 2e^{-2x}\).
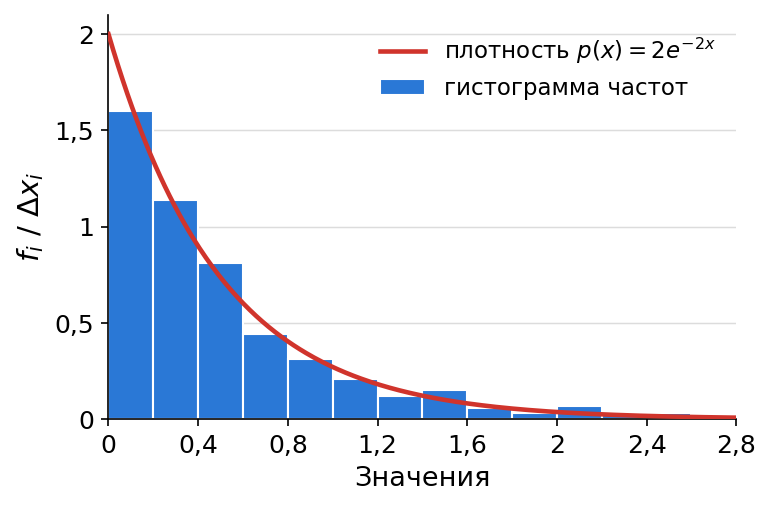
Гистограмма повторяет форму плотности: высоты столбиков убывают от \(1{,}6\) над первым интервалом (плотность в его середине \(1{,}6375\)) почти до нуля, как кривая \(2e^{-2x}\); заметнее всего они отличаются от кривой справа, где в интервал попадает лишь несколько значений.
На этапе 7 меняем значение в ячейке D1 — для каждого \(\lambda\) получается новая серия. При \(\lambda = 1\) получилось \(\overline{Y} \approx 1{,}070\), \(S^2 \approx 0{,}994\), \(S \approx 0{,}997\) (теория: \(E(Y) = 1\), \(D(Y) = 1\), \(\sigma = 1\)), а при \(\lambda = 4\) — \(\overline{Y} \approx 0{,}234\), \(S^2 \approx 0{,}052\), \(S \approx 0{,}228\) (теория: \(E(Y) = 0{,}25\), \(D(Y) = 0{,}0625\), \(\sigma = 0{,}25\)). С ростом \(\lambda\) значения выборки теснее прижимаются к нулю: выборочные среднее и стандартное отклонение уменьшаются, оставаясь близкими к \(\frac{1}{\lambda}\), а выборочная дисперсия — к \(\frac{1}{\lambda^2}\); график плотности начинается на высоте \(\lambda\) и убывает тем быстрее, чем больше \(\lambda\), и гистограмма следует за ним.
То же моделирование — программа на Python; она печатает те же числа, что получены выше:
from math import log, exp

def slchis(seed):                       # датчик случайных чисел из (0; 1), как СЛЧИС()
    x = seed
    while True:
        x = (6364136223846793005 * x + 1442695040888963407) % 2 ** 64
        yield (x >> 11) / 2 ** 53

lam, N, h = 2, 500, 0.2                 # λ (ячейка D1), объём выборки, ширина интервала
rnd = slchis(214)                       # номер серии
y = [-log(1 - next(rnd)) / lam for i in range(N)]   # столбец B: =-LN(1-A1)/$D$1
m = sum(y) / N                                     # C2: выборочное среднее
d = sum((v - m) ** 2 for v in y) / N               # C3: выборочная дисперсия (на N)
print('выборка: среднее %.3f, дисперсия %.3f, ст. отклонение %.3f' % (m, d, d ** 0.5))
print('теория:  E = %g, D = %g, σ = %g' % (1 / lam, 1 / lam ** 2, 1 / lam))
k = 0
while k * h <= max(y):                             # интервалы [kh; (k + 1)h) до наибольшего значения
    n = sum(k * h <= v < (k + 1) * h for v in y)   # столбец G
    print('%.1f–%.1f: %3d  высота %.2f  плотность %.4f' % (k * h, (k + 1) * h, n, n / N / h, lam * exp(-lam * (k + 0.5) * h)))
    k += 1
Задание 2. Моделирование нормальной случайной величины.
Моделируем 500 значений нормальной случайной величины с параметрами \(a = 2\) и \(\sigma = 0{,}8\), т. е. \(\sigma^2 = 0{,}64\); лист устроен так же, как в задании 1, числа и графики — для одной серии случайных чисел.
В ячейку D1 вписываем \(a = 2\), в ячейку D2 — \(\sigma = 0{,}8\), в ячейку D3 — =D2^2 (дисперсия \(\sigma^2 = 0{,}64\)); столбец A заполняем формулой =СЛЧИС(). В ячейку B1 вписываем =НОРМОБР(A1;$D$1;$D$2) и копируем вниз до B500: функция НОРМОБР() — обратная к функции распределения нормального закона, поэтому в столбце B получаются значения нормальной величины \(Y\) с параметрами \(a = 2\) и \(\sigma^2 = 0{,}64\); третий аргумент функции — стандартное отклонение \(\sigma\) (ячейка D2), а не дисперсия.
Первые 10 строк листа в этой серии (округления те же, что в задании 1):
\[\begin{array}{|c|c|c|} \hline \text{Строка} & \text{A} & \text{B} \\ \hline 1 & 0{,}2134 & 1{,}364 \\ \hline 2 & 0{,}2541 & 1{,}471 \\ \hline 3 & 0{,}0881 & 0{,}918 \\ \hline 4 & 0{,}3721 & 1{,}739 \\ \hline 5 & 0{,}1114 & 1{,}025 \\ \hline 6 & 0{,}4474 & 1{,}894 \\ \hline 7 & 0{,}9371 & 3{,}225 \\ \hline 8 & 0{,}0715 & 0{,}828 \\ \hline 9 & 0{,}1880 & 1{,}292 \\ \hline 10 & 0{,}4099 & 1{,}818 \\ \hline \end{array}\]
В ячейки C2, C3 и C4 вписываем те же формулы, что в задании 1: =СРЗНАЧ(B1:B500), =ДИСПР(B1:B500) и =СТАНДОТКЛОНП(B1:B500). В этой серии \(\overline{Y} \approx 1{,}999\), \(S^2 \approx 0{,}626\), \(S \approx 0{,}791\), а теоретические значения \(E(Y) = a = 2\), \(D(Y) = \sigma^2 = 0{,}64\) и \(\sigma = 0{,}8\) записаны в ячейках D1, D3 и D2: выборочные характеристики отличаются от них меньше чем на \(0{,}015\).
Для гистограммы берём интервалы длины \(0{,}4\) от \(a - 3\sigma = -0{,}4\) до \(a + 3\sigma = 4{,}4\) — 12 интервалов, расположенных симметрично относительно \(a = 2\); все значения выборки (наименьшее \(-0{,}129\), наибольшее \(4{,}177\)) попадают в этот промежуток. В ячейку E1 вписываем \(-0{,}4\), в ячейку F1 — =E1+0,4, в ячейку E2 — =F1; ячейку E2 копируем вниз до E12, а ячейку F1 — до F12. В ячейку G1 вписываем ту же формулу, что в задании 1: =СЧЁТЕСЛИ($B$1:$B$500;"<"&F1)-СЧЁТЕСЛИ($B$1:$B$500;"<"&E1), в ячейку H1 — =G1/500/0,4, в ячейку I1 — =НОРМРАСП((E1+F1)/2;$D$1;$D$2;0), плотность нормального распределения в середине интервала (четвёртый аргумент 0 означает плотность, 1 — функцию распределения). Формулы столбцов G, H и I копируем вниз до строки 12:
\[\begin{array}{l|c|c|c|c|c|c} \text{E} & -0{,}4 & 0 & 0{,}4 & 0{,}8 & 1{,}2 & 1{,}6 \\ \hline \text{F} & 0 & 0{,}4 & 0{,}8 & 1{,}2 & 1{,}6 & 2 \\ \hline \text{G} & 3 & 7 & 24 & 43 & 75 & 100 \\ \hline \text{H} & 0{,}015 & 0{,}035 & 0{,}12 & 0{,}215 & 0{,}375 & 0{,}5 \\ \hline \text{I} & 0{,}0114 & 0{,}0397 & 0{,}1078 & 0{,}2283 & 0{,}3764 & 0{,}4833 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c} \text{E} & 2 & 2{,}4 & 2{,}8 & 3{,}2 & 3{,}6 & 4 \\ \hline \text{F} & 2{,}4 & 2{,}8 & 3{,}2 & 3{,}6 & 4 & 4{,}4 \\ \hline \text{G} & 102 & 71 & 39 & 21 & 12 & 3 \\ \hline \text{H} & 0{,}51 & 0{,}355 & 0{,}195 & 0{,}105 & 0{,}06 & 0{,}015 \\ \hline \text{I} & 0{,}4833 & 0{,}3764 & 0{,}2283 & 0{,}1078 & 0{,}0397 & 0{,}0114 \end{array}\]
По столбцам H и I строим на одном графике гистограмму частот и график плотности распределения \(N(2;\ 0{,}64)\).
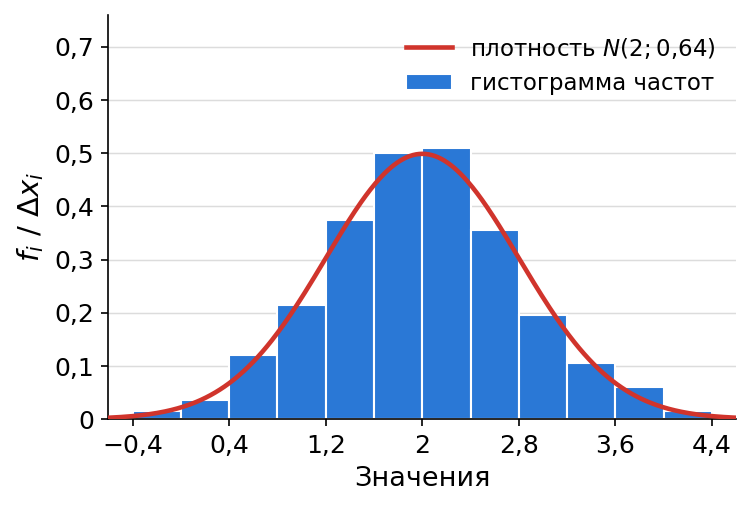
Гистограмма похожа на колокол плотности: самые высокие столбики (\(0{,}5\) и \(0{,}51\)) стоят над двумя интервалами по обе стороны от \(a = 2\), где плотность наибольшая (\(p(2) \approx 0{,}4987\)), а к краям высоты столбиков убывают почти симметрично, как кривая.
Нормальная величина \(Y\) попадает в интервал \((a - k\sigma;\ a + k\sigma)\) с вероятностью \(2\Phi_0(k)\). Число значений в интервале \((1{,}2;\ 2{,}8)\) — сумма ячеек G5:G8, в интервале \((0{,}4;\ 3{,}6)\) — сумма ячеек G3:G10, а доли дают формулы =СУММ(G5:G8)/500 и =СУММ(G3:G10)/500:
\[\begin{array}{l|c|c|c} \text{Интервал} & (1{,}2;\ 2{,}8) & (0{,}4;\ 3{,}6) & ({-0{,}4};\ 4{,}4) \\ \hline k & 1 & 2 & 3 \\ \hline \text{Число значений} & 348 & 475 & 500 \\ \hline \text{Доля} & 0{,}696 & 0{,}95 & 1 \\ \hline 2\Phi_0(k) & 0{,}6826 & 0{,}9546 & 0{,}9974 \end{array}\]
Доли значений близки к теоретическим вероятностям. В интервал \((a - 3\sigma;\ a + 3\sigma)\) попали все 500 значений: за его пределы в среднем выходит лишь \(500 \cdot 0{,}0026 = 1{,}3\) значения из 500.
То же моделирование — программа на Python; она печатает те же числа, что получены выше:
from statistics import NormalDist

def slchis(seed):                       # датчик случайных чисел из (0; 1), как СЛЧИС()
    x = seed
    while True:
        x = (6364136223846793005 * x + 1442695040888963407) % 2 ** 64
        yield (x >> 11) / 2 ** 53

a, s, N, h = 2, 0.8, 500, 0.4           # a (ячейка D1), σ (D2), объём выборки, ширина интервала
nd = NormalDist(a, s)
rnd = slchis(383)                       # номер серии
y = [nd.inv_cdf(next(rnd)) for i in range(N)]      # столбец B: =НОРМОБР(A1;$D$1;$D$2)
m = sum(y) / N
d = sum((v - m) ** 2 for v in y) / N
print('выборка: среднее %.3f, дисперсия %.3f, ст. отклонение %.3f' % (m, d, d ** 0.5))
print('теория:  E = %g, D = %g, σ = %g' % (a, s ** 2, s))
for k in range(12):                                # интервалы от a − 3σ до a + 3σ
    left = round(a - 3 * s + k * h, 6) + 0
    n = sum(left <= v < left + h for v in y)
    print('%.1f–%.1f: %3d  высота %.3f  плотность %.4f' % (left, left + h, n, n / N / h, nd.pdf(left + h / 2)))
Ответ: задание 1 — величина \(Y = -\frac{\ln(1 - X)}{\lambda}\), где \(X\) — значение функции СЛЧИС(), имеет показательное распределение с параметром \(\lambda\): при \(\lambda = 2\) её выборочные среднее, дисперсия и стандартное отклонение близки к теоретическим \(E(Y) = \frac{1}{\lambda} = 0{,}5\), \(D(Y) = \frac{1}{\lambda^2} = 0{,}25\), \(\sigma = \frac{1}{\lambda} = 0{,}5\), гистограмма частот повторяет график плотности \(2e^{-2x}\), а при изменении \(\lambda\) выборочные среднее и стандартное отклонение остаются близкими к \(\frac{1}{\lambda}\); задание 2 — формула =НОРМОБР(A1;$D$1;$D$2) даёт нормальную величину: при \(a = 2\), \(\sigma = 0{,}8\) её выборочные характеристики близки к теоретическим \(E(Y) = 2\), \(D(Y) = 0{,}64\), \(\sigma = 0{,}8\), гистограмма частот повторяет колокол плотности \(N(2;\ 0{,}64)\), а доли значений в интервалах \((a - k\sigma;\ a + k\sigma)\) близки к \(2\Phi_0(k)\), т. е. к \(0{,}6826\); \(0{,}9546\); \(0{,}9974\) при \(k = 1\), 2, 3.
Задание 1. Моделирование показательной случайной величины.
Смоделируем в электронной таблице 500 значений показательной случайной величины с параметром \(\lambda = 2\). Формулы годятся для любой серии случайных чисел; числа и графики приведём для одной серии случайных чисел — после нажатия клавиши F9 серия будет другой.
На этапе 1 вписываем в ячейку D1 значение \(\lambda = 2\).
На этапе 2 вписываем в ячейку A1 формулу =СЛЧИС() и копируем её вниз до A500: столбец A — 500 значений случайной величины \(X\), равномерно распределённой на промежутке \((0;\ 1)\).
На этапе 3 вписываем в ячейку B1 формулу =-LN(1-A1)/$D$1 и копируем её вниз до B500. Функция распределения показательного закона \(F(x) = 1 - e^{-\lambda x}\) (\(x \geqslant 0\)) возрастает от 0 до 1, и из равенства \(y = 1 - e^{-\lambda x}\) получаем обратную функцию \(x = -\frac{\ln(1 - y)}{\lambda}\). Поэтому величина \(Y = -\frac{\ln(1 - X)}{\lambda}\) имеет показательное распределение с параметром \(\lambda\): при \(y \geqslant 0\) неравенство \(Y < y\) равносильно неравенству \(X < 1 - e^{-\lambda y}\), и \(P(Y < y) = 1 - e^{-\lambda y}\). Адрес A1 относительный: при копировании он меняется на A2, A3, …, и каждая строка берёт своё случайное число. Адрес $D$1 абсолютный: при копировании он не меняется, и все строки делят на одно и то же \(\lambda\) (относительный адрес D1 в строке 2 превратился бы в D2, где записано другое число).
Первые 10 строк листа в этой серии (числа в столбце A округлены до десятитысячных, в столбце B — до тысячных):
\[\begin{array}{|c|c|c|} \hline \text{Строка} & \text{A} & \text{B} \\ \hline 1 & 0{,}9083 & 1{,}195 \\ \hline 2 & 0{,}3514 & 0{,}216 \\ \hline 3 & 0{,}8150 & 0{,}844 \\ \hline 4 & 0{,}4737 & 0{,}321 \\ \hline 5 & 0{,}5135 & 0{,}360 \\ \hline 6 & 0{,}6463 & 0{,}520 \\ \hline 7 & 0{,}6917 & 0{,}588 \\ \hline 8 & 0{,}1761 & 0{,}097 \\ \hline 9 & 0{,}8664 & 1{,}006 \\ \hline 10 & 0{,}3451 & 0{,}212 \\ \hline \end{array}\]
Например, в первой строке \(-\frac{\ln(1 - 0{,}9083)}{2} = -\frac{\ln 0{,}0917}{2} \approx 1{,}195\).
На этапе 4 вписываем в ячейки C2, C3 и C4 формулы =СРЗНАЧ(B1:B500), =ДИСПР(B1:B500) и =СТАНДОТКЛОНП(B1:B500) — выборочное среднее \(\overline{Y}\), выборочную дисперсию \(S^2\) (сумма квадратов отклонений от \(\overline{Y}\) делится на объём выборки \(N = 500\)) и стандартное отклонение \(S = \sqrt{S^2}\). В этой серии \(\overline{Y} \approx 0{,}503\), \(S^2 \approx 0{,}248\), \(S \approx 0{,}498\).
На этапе 5 вписываем в ячейки D2, D3 и D4 формулы =1/D1, =1/D1^2 и =1/D1 — математическое ожидание \(E(Y) = \frac{1}{\lambda}\), дисперсию \(D(Y) = \frac{1}{\lambda^2}\) и стандартное отклонение \(\sigma = \sqrt{D(Y)} = \frac{1}{\lambda}\) показательного закона. При \(\lambda = 2\) получаем \(E(Y) = 0{,}5\), \(D(Y) = 0{,}25\), \(\sigma = 0{,}5\): выборочные характеристики \(0{,}503\); \(0{,}248\); \(0{,}498\) отличаются от теоретических меньше чем на \(0{,}005\).
На этапе 6 строим гистограмму частот и график плотности. Наименьшее значение выборки равно \(0{,}0015\), наибольшее — \(2{,}692\), поэтому разобьём промежуток от 0 до \(2{,}8\) на 14 интервалов длины \(0{,}2\). В ячейку E1 вписываем 0 — левый конец первого интервала, в ячейку F1 — =E1+0,2 (его правый конец), в ячейку E2 — =F1; ячейку E2 копируем вниз до E14, а ячейку F1 — до F14.
В ячейку G1 вписываем =СЧЁТЕСЛИ($B$1:$B$500;"<"&F1)-СЧЁТЕСЛИ($B$1:$B$500;"<"&E1) и копируем вниз до G14. Условие "<"&F1 означает «значения, меньшие числа из ячейки F1», поэтому разность — число значений выборки в интервале от числа из E1 (включительно) до числа из F1. Диапазон $B$1:$B$500 закреплён, а адреса E1 и F1 при копировании сдвигаются вниз вместе со строкой.
Высота столбика гистограммы — частота интервала, делённая на его длину: в ячейку H1 вписываем =G1/500/0,2 и копируем вниз до H14. Тогда площадь каждого столбика равна частоте интервала, а сумма площадей — 1, как площадь под графиком плотности, поэтому гистограмму и плотность можно сравнивать на одном графике. В ячейку I1 вписываем =$D$1*EXP(-$D$1*(E1+F1)/2) и копируем вниз до I14 — это значение плотности \(p(x) = \lambda e^{-\lambda x}\) в середине интервала; EXP(x) — число \(e\) в степени \(x\).
Получаем таблицу; её строки — столбцы листа: E и F — концы интервала, G — число значений в нём, H — высота столбика, I — плотность в середине интервала (округлена до десятитысячных):
\[\begin{array}{l|c|c|c|c|c|c|c} \text{E} & 0 & 0{,}2 & 0{,}4 & 0{,}6 & 0{,}8 & 1 & 1{,}2 \\ \hline \text{F} & 0{,}2 & 0{,}4 & 0{,}6 & 0{,}8 & 1 & 1{,}2 & 1{,}4 \\ \hline \text{G} & 160 & 114 & 81 & 44 & 31 & 21 & 12 \\ \hline \text{H} & 1{,}6 & 1{,}14 & 0{,}81 & 0{,}44 & 0{,}31 & 0{,}21 & 0{,}12 \\ \hline \text{I} & 1{,}6375 & 1{,}0976 & 0{,}7358 & 0{,}4932 & 0{,}3306 & 0{,}2216 & 0{,}1485 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c|c} \text{E} & 1{,}4 & 1{,}6 & 1{,}8 & 2 & 2{,}2 & 2{,}4 & 2{,}6 \\ \hline \text{F} & 1{,}6 & 1{,}8 & 2 & 2{,}2 & 2{,}4 & 2{,}6 & 2{,}8 \\ \hline \text{G} & 15 & 6 & 3 & 7 & 2 & 3 & 1 \\ \hline \text{H} & 0{,}15 & 0{,}06 & 0{,}03 & 0{,}07 & 0{,}02 & 0{,}03 & 0{,}01 \\ \hline \text{I} & 0{,}0996 & 0{,}0667 & 0{,}0447 & 0{,}03 & 0{,}0201 & 0{,}0135 & 0{,}009 \end{array}\]
Сумма чисел столбца G равна 500 — все значения выборки учтены. По столбцам H и I построим на одном графике гистограмму частот и график плотности \(p(x) = 2e^{-2x}\).
Гистограмма повторяет форму плотности: высоты столбиков убывают от \(1{,}6\) над первым интервалом (плотность в его середине \(1{,}6375\)) почти до нуля, как кривая \(2e^{-2x}\). Заметнее всего столбики отличаются от кривой справа, где в интервал попадает лишь несколько значений: например, в интервал от \(1{,}4\) до \(1{,}6\) попало 15 значений, а в среднем их должно быть \(500 \cdot (F(1{,}6) - F(1{,}4)) = 500 \cdot (e^{-2{,}8} - e^{-3{,}2}) \approx 10\).
На этапе 7 меняем значение в ячейке D1. При каждом изменении листа функция СЛЧИС() вычисляется заново, поэтому для каждого \(\lambda\) получается новая серия. В наших сериях при \(\lambda = 1\) получилось \(\overline{Y} \approx 1{,}070\), \(S^2 \approx 0{,}994\), \(S \approx 0{,}997\) (теория: \(E(Y) = 1\), \(D(Y) = 1\), \(\sigma = 1\)), а при \(\lambda = 4\) — \(\overline{Y} \approx 0{,}234\), \(S^2 \approx 0{,}052\), \(S \approx 0{,}228\) (теория: \(E(Y) = 0{,}25\), \(D(Y) = 0{,}0625\), \(\sigma = 0{,}25\)). С ростом \(\lambda\) значения выборки теснее прижимаются к нулю: выборочные среднее и стандартное отклонение уменьшаются, оставаясь близкими к \(\frac{1}{\lambda}\), а выборочная дисперсия — к \(\frac{1}{\lambda^2}\); график плотности начинается на высоте \(\lambda\) и убывает тем быстрее, чем больше \(\lambda\), и гистограмма следует за ним.
Значит, величина \(Y = -\frac{\ln(1 - X)}{\lambda}\), полученная из случайных чисел СЛЧИС(), ведёт себя как показательная: её выборочные среднее, дисперсия и стандартное отклонение близки к теоретическим \(\frac{1}{\lambda}\), \(\frac{1}{\lambda^2}\) и \(\frac{1}{\lambda}\), а гистограмма частот повторяет график плотности.
То же моделирование — программа на Python; она печатает те же числа, что получены выше:
from math import log, exp

def slchis(seed):                       # датчик случайных чисел из (0; 1), как СЛЧИС()
    x = seed
    while True:
        x = (6364136223846793005 * x + 1442695040888963407) % 2 ** 64
        yield (x >> 11) / 2 ** 53

lam, N, h = 2, 500, 0.2                 # λ (ячейка D1), объём выборки, ширина интервала
rnd = slchis(214)                       # номер серии
y = [-log(1 - next(rnd)) / lam for i in range(N)]   # столбец B: =-LN(1-A1)/$D$1
m = sum(y) / N                                     # C2: выборочное среднее
d = sum((v - m) ** 2 for v in y) / N               # C3: выборочная дисперсия (на N)
print('выборка: среднее %.3f, дисперсия %.3f, ст. отклонение %.3f' % (m, d, d ** 0.5))
print('теория:  E = %g, D = %g, σ = %g' % (1 / lam, 1 / lam ** 2, 1 / lam))
k = 0
while k * h <= max(y):                             # интервалы [kh; (k + 1)h) до наибольшего значения
    n = sum(k * h <= v < (k + 1) * h for v in y)   # столбец G
    print('%.1f–%.1f: %3d  высота %.2f  плотность %.4f' % (k * h, (k + 1) * h, n, n / N / h, lam * exp(-lam * (k + 0.5) * h)))
    k += 1
Задание 2. Моделирование нормальной случайной величины.
Смоделируем 500 значений нормальной случайной величины; возьмём для примера параметры \(a = 2\) и \(\sigma = 0{,}8\), т. е. \(\sigma^2 = 0{,}64\). Лист устроим так же, как в задании 1; числа и графики приведём для одной серии случайных чисел.
В ячейку D1 вписываем \(a = 2\), в ячейку D2 — \(\sigma = 0{,}8\), в ячейку D3 — =D2^2 (дисперсия \(\sigma^2 = 0{,}64\)). Столбец A, как в задании 1, заполняем формулой =СЛЧИС(). В ячейку B1 вписываем =НОРМОБР(A1;$D$1;$D$2) и копируем вниз до B500. Функция НОРМОБР() — обратная к функции распределения нормального закона с параметрами \(a\) и \(\sigma^2\), поэтому в столбце B получаются значения нормальной величины \(Y\) с параметрами \(a = 2\) и \(\sigma^2 = 0{,}64\); третий аргумент функции — стандартное отклонение \(\sigma\) (ячейка D2), а не дисперсия.
Первые 10 строк листа в этой серии (округления те же, что в задании 1):
\[\begin{array}{|c|c|c|} \hline \text{Строка} & \text{A} & \text{B} \\ \hline 1 & 0{,}2134 & 1{,}364 \\ \hline 2 & 0{,}2541 & 1{,}471 \\ \hline 3 & 0{,}0881 & 0{,}918 \\ \hline 4 & 0{,}3721 & 1{,}739 \\ \hline 5 & 0{,}1114 & 1{,}025 \\ \hline 6 & 0{,}4474 & 1{,}894 \\ \hline 7 & 0{,}9371 & 3{,}225 \\ \hline 8 & 0{,}0715 & 0{,}828 \\ \hline 9 & 0{,}1880 & 1{,}292 \\ \hline 10 & 0{,}4099 & 1{,}818 \\ \hline \end{array}\]
В ячейки C2, C3 и C4 вписываем те же формулы, что в задании 1: =СРЗНАЧ(B1:B500), =ДИСПР(B1:B500) и =СТАНДОТКЛОНП(B1:B500). В этой серии \(\overline{Y} \approx 1{,}999\), \(S^2 \approx 0{,}626\), \(S \approx 0{,}791\), а теоретические значения \(E(Y) = a = 2\), \(D(Y) = \sigma^2 = 0{,}64\) и \(\sigma = 0{,}8\) записаны в ячейках D1, D3 и D2: выборочные характеристики отличаются от них меньше чем на \(0{,}015\).
Для гистограммы возьмём интервалы длины \(0{,}4\) от \(a - 3\sigma = -0{,}4\) до \(a + 3\sigma = 4{,}4\) — 12 интервалов, расположенных симметрично относительно \(a = 2\); все значения выборки (наименьшее \(-0{,}129\), наибольшее \(4{,}177\)) попадают в этот промежуток. В ячейку E1 вписываем \(-0{,}4\), в ячейку F1 — =E1+0,4, в ячейку E2 — =F1; ячейку E2 копируем вниз до E12, а ячейку F1 — до F12. В ячейку G1 вписываем ту же формулу, что в задании 1: =СЧЁТЕСЛИ($B$1:$B$500;"<"&F1)-СЧЁТЕСЛИ($B$1:$B$500;"<"&E1) — число значений в интервале. В ячейку H1 вписываем =G1/500/0,4 — частоту интервала, делённую на его длину, а в ячейку I1 — =НОРМРАСП((E1+F1)/2;$D$1;$D$2;0), плотность нормального распределения в середине интервала (четвёртый аргумент 0 означает плотность, 1 — функцию распределения). Формулы столбцов G, H и I копируем вниз до строки 12. Получаем:
\[\begin{array}{l|c|c|c|c|c|c} \text{E} & -0{,}4 & 0 & 0{,}4 & 0{,}8 & 1{,}2 & 1{,}6 \\ \hline \text{F} & 0 & 0{,}4 & 0{,}8 & 1{,}2 & 1{,}6 & 2 \\ \hline \text{G} & 3 & 7 & 24 & 43 & 75 & 100 \\ \hline \text{H} & 0{,}015 & 0{,}035 & 0{,}12 & 0{,}215 & 0{,}375 & 0{,}5 \\ \hline \text{I} & 0{,}0114 & 0{,}0397 & 0{,}1078 & 0{,}2283 & 0{,}3764 & 0{,}4833 \end{array}\] \[\begin{array}{l|c|c|c|c|c|c} \text{E} & 2 & 2{,}4 & 2{,}8 & 3{,}2 & 3{,}6 & 4 \\ \hline \text{F} & 2{,}4 & 2{,}8 & 3{,}2 & 3{,}6 & 4 & 4{,}4 \\ \hline \text{G} & 102 & 71 & 39 & 21 & 12 & 3 \\ \hline \text{H} & 0{,}51 & 0{,}355 & 0{,}195 & 0{,}105 & 0{,}06 & 0{,}015 \\ \hline \text{I} & 0{,}4833 & 0{,}3764 & 0{,}2283 & 0{,}1078 & 0{,}0397 & 0{,}0114 \end{array}\]
По столбцам H и I построим на одном графике гистограмму частот и график плотности распределения \(N(2;\ 0{,}64)\).
Гистограмма похожа на колокол плотности: самые высокие столбики (\(0{,}5\) и \(0{,}51\)) стоят над двумя интервалами по обе стороны от \(a = 2\), где плотность наибольшая (\(p(2) \approx 0{,}4987\)), а к краям высоты столбиков убывают почти симметрично, как кривая.
Сравним с теорией ещё доли значений, попавших в интервалы \((a - k\sigma;\ a + k\sigma)\). Функция распределения нормальной величины \(Y\) равна \(F(x) = \Phi_0\left(\frac{x - a}{\sigma}\right) + 0{,}5\), а функция Лапласа нечётна, поэтому \(P(a - k\sigma < Y < a + k\sigma) = F(a + k\sigma) - F(a - k\sigma) = \Phi_0(k) - \Phi_0(-k) = 2\Phi_0(k)\). Число значений в интервале \((1{,}2;\ 2{,}8)\) — сумма ячеек G5:G8, в интервале \((0{,}4;\ 3{,}6)\) — сумма ячеек G3:G10, а доли дают формулы =СУММ(G5:G8)/500 и =СУММ(G3:G10)/500:
\[\begin{array}{l|c|c|c} \text{Интервал} & (1{,}2;\ 2{,}8) & (0{,}4;\ 3{,}6) & ({-0{,}4};\ 4{,}4) \\ \hline k & 1 & 2 & 3 \\ \hline \text{Число значений} & 348 & 475 & 500 \\ \hline \text{Доля} & 0{,}696 & 0{,}95 & 1 \\ \hline 2\Phi_0(k) & 0{,}6826 & 0{,}9546 & 0{,}9974 \end{array}\]
Доли значений близки к теоретическим вероятностям. В интервал \((a - 3\sigma;\ a + 3\sigma)\) попали все 500 значений: за его пределы в среднем выходит лишь \(500 \cdot 0{,}0026 = 1{,}3\) значения из 500.
Значит, выборка, полученная функцией НОРМОБР() из случайных чисел СЛЧИС(), ведёт себя как нормальная величина с параметрами \(a = 2\) и \(\sigma = 0{,}8\): выборочные характеристики близки к теоретическим, гистограмма повторяет колокол плотности, а доли значений в интервалах \((a - k\sigma;\ a + k\sigma)\) близки к \(2\Phi_0(k)\).
То же моделирование — программа на Python; она печатает те же числа, что получены выше:
from statistics import NormalDist

def slchis(seed):                       # датчик случайных чисел из (0; 1), как СЛЧИС()
    x = seed
    while True:
        x = (6364136223846793005 * x + 1442695040888963407) % 2 ** 64
        yield (x >> 11) / 2 ** 53

a, s, N, h = 2, 0.8, 500, 0.4           # a (ячейка D1), σ (D2), объём выборки, ширина интервала
nd = NormalDist(a, s)
rnd = slchis(383)                       # номер серии
y = [nd.inv_cdf(next(rnd)) for i in range(N)]      # столбец B: =НОРМОБР(A1;$D$1;$D$2)
m = sum(y) / N
d = sum((v - m) ** 2 for v in y) / N
print('выборка: среднее %.3f, дисперсия %.3f, ст. отклонение %.3f' % (m, d, d ** 0.5))
print('теория:  E = %g, D = %g, σ = %g' % (a, s ** 2, s))
for k in range(12):                                # интервалы от a − 3σ до a + 3σ
    left = round(a - 3 * s + k * h, 6) + 0
    n = sum(left <= v < left + h for v in y)
    print('%.1f–%.1f: %3d  высота %.3f  плотность %.4f' % (left, left + h, n, n / N / h, nd.pdf(left + h / 2)))
Ответ: задание 1 — величина \(Y = -\frac{\ln(1 - X)}{\lambda}\), где \(X\) — значение функции СЛЧИС(), имеет показательное распределение с параметром \(\lambda\): при \(\lambda = 2\) её выборочные среднее, дисперсия и стандартное отклонение близки к теоретическим \(E(Y) = \frac{1}{\lambda} = 0{,}5\), \(D(Y) = \frac{1}{\lambda^2} = 0{,}25\), \(\sigma = \frac{1}{\lambda} = 0{,}5\), гистограмма частот повторяет график плотности \(2e^{-2x}\), а при изменении \(\lambda\) выборочные среднее и стандартное отклонение остаются близкими к \(\frac{1}{\lambda}\); задание 2 — формула =НОРМОБР(A1;$D$1;$D$2) даёт нормальную величину: при \(a = 2\), \(\sigma = 0{,}8\) её выборочные характеристики близки к теоретическим \(E(Y) = 2\), \(D(Y) = 0{,}64\), \(\sigma = 0{,}8\), гистограмма частот повторяет колокол плотности \(N(2;\ 0{,}64)\), а доли значений в интервалах \((a - k\sigma;\ a + k\sigma)\) близки к \(2\Phi_0(k)\), т. е. к \(0{,}6826\); \(0{,}9546\); \(0{,}9974\) при \(k = 1\), 2, 3.


